

💖 支持这个项目
📊 已被 7000+ WorkBuddy 用户下载使用,覆盖 SkillHub & ClawHub 双平台。
如果这个工具帮到了你,欢迎:
- ⭐ 去 GitHub 点个 Star
- 🐛 遇到问题提 Issue
- 📢 分享给你的 WorkBuddy 用户朋友
GitHub:https://github.com/clancy-feng/workbuddy-usage-status
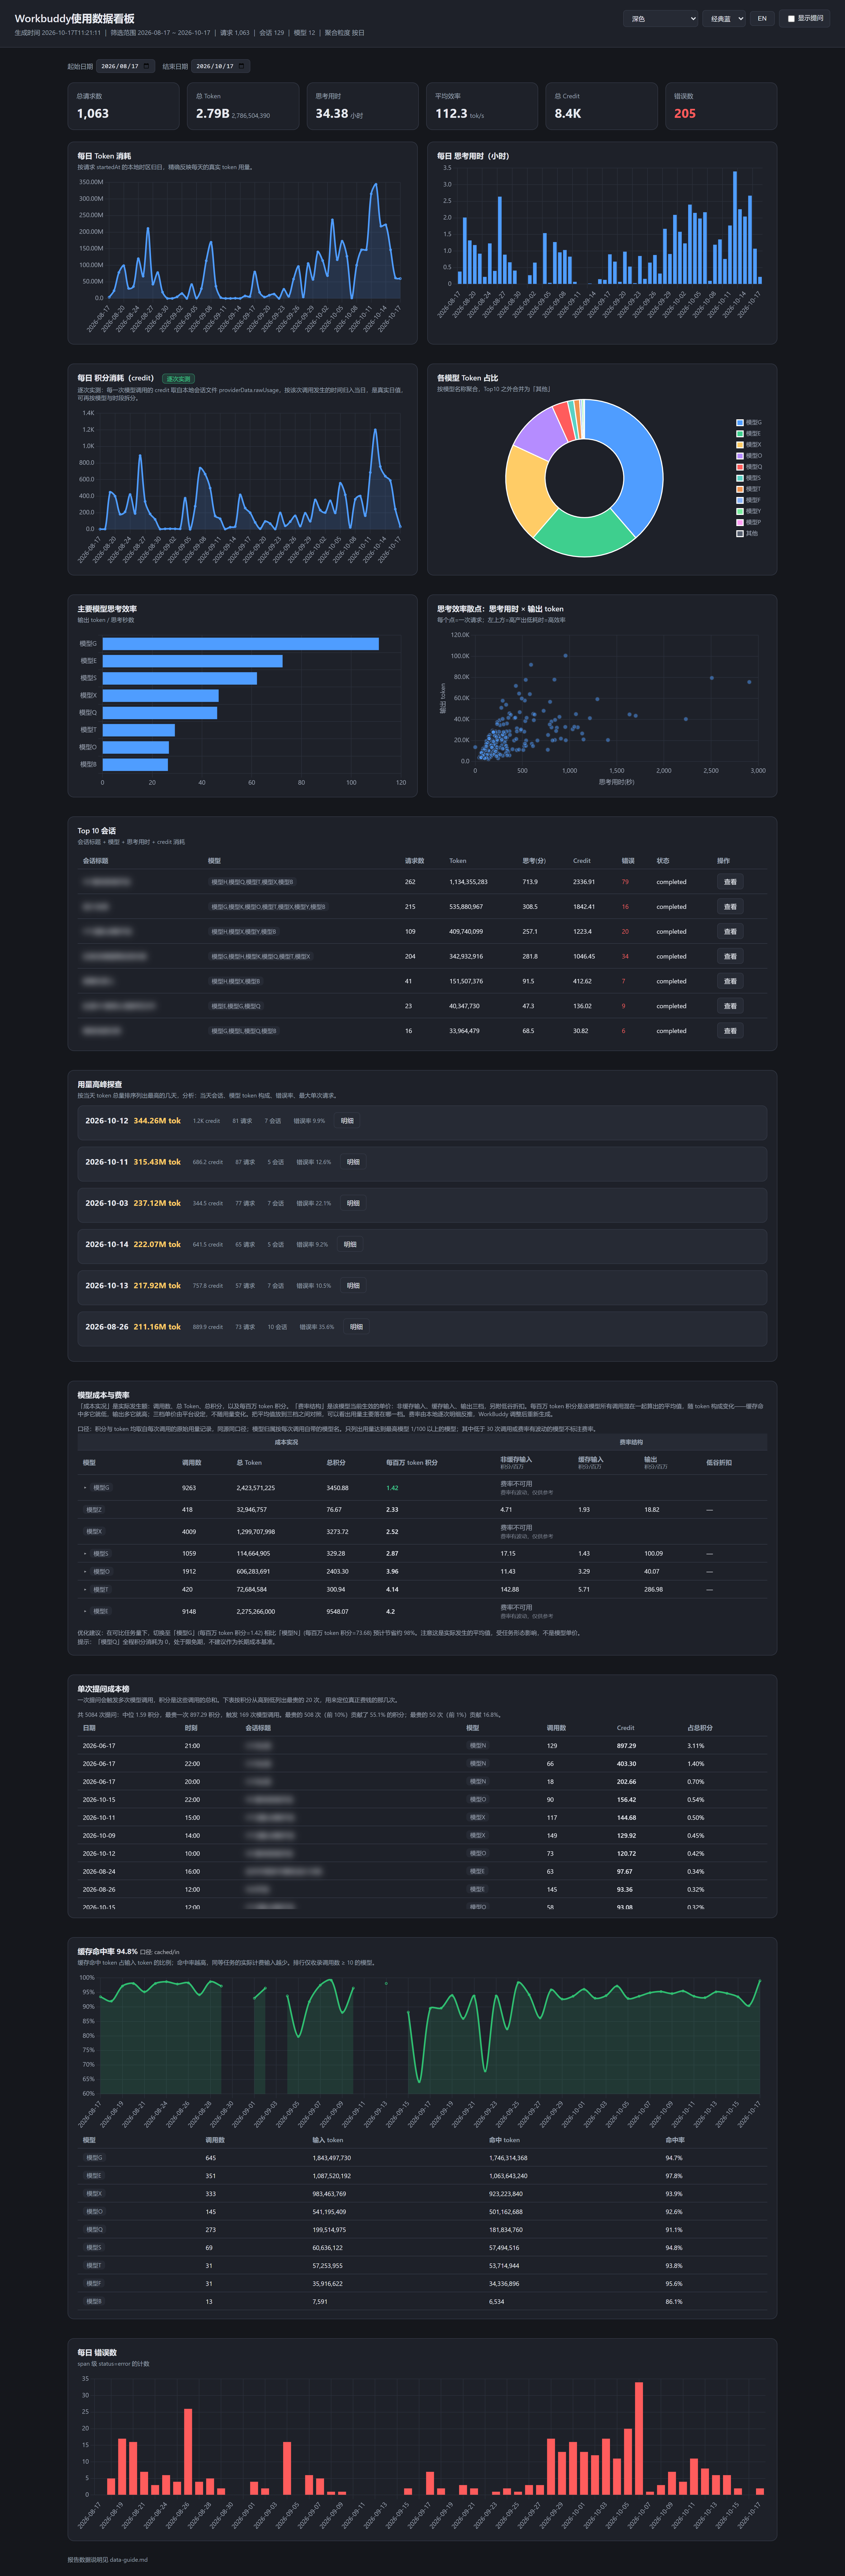
界面预览
技能简介
把 WorkBuddy 自己的本地使用数据,变成一份离线可查的 Dashboard。
可以看到:token 消耗、思考用时、思考效率、模型分布、错误数、积分消耗、模型费率、单次提问成本。
✨ 核心功能特性
- Token/Credit 全链路可视化:按模型、按日期、按会话统计,一眼定位"烧钱大户"
- 用量高峰探查:按 token 列出最高的几天,单行显示 token、credit、请求数、会话数、错误率,点「明细」展开当天会话表与模型 Top5
- 模型成本与费率:同一张表并排两类信息。一类是实际用量与花费,含调用数 / token / 积分 / 每百万 token 积分,按每次调用真实的模型名归属;另一类是从本地逐次明细反推的单价,含非缓存输入 / 缓存输入 / 输出三档单价与低谷折扣。
- 单次提问成本榜:一次提问会触发多次模型调用,按积分列出最贵的 20 次,并给出集中度,即最贵的 1% 与 10% 提问各贡献多少积分,用于定位真正费钱的那几次
- 思考效率量化:输出 token ÷ 思考秒数,即 tok/s,横向对比模型思考效率
- 错误集中监控:快速定位报错频繁的会话/模型,降低调试成本,可导出错误详情。
- 离线运行:Chart.js 随包附带,零外网依赖
- 缓存命中率面板:整体与按模型命中率趋势,看清"谁在帮你省钱";口径为 cached/input,实测 cached>input 时自动切换并标注
- 三级下钻:从 Top10 会话点「查看」,轮次表含时间 / 模型 / 状态 / Token / 输入 / 缓存命中 / 调用数 / 工具数 / 思考时长 / 错误;提问列默认隐藏,勾选「显示提问」展开,展示时脱敏;每轮再点「明细」看事件摘要,含生成段数与总时长、工具调用清单及耗时、错误类型与摘要
- 全量数据双格式同步生成:每次运行自动产出
usage-full-<时间戳>.csv与usage-full-<时间戳>.xlsx,两者同源、同为 14 个分区。CSV 把 14 个分区写在同一个文件里;xlsx 把每个分区放进独立工作表并冻结首行。表头与分区名语言自动跟随操作系统语言切换 - 自动归档合并:每次运行自动把逐笔数据并入本地归档(traceId 去重),WorkBuddy 30 天清理 trace 也不再丢历史——对用户完全透明,
--no-archive可关。归档内容是逐请求事实、会话汇总与每日总量,不含提问原文与 credit 明细。 - 只读无侵入:以只读模式访问 WorkBuddy 数据,不影响正在运行的程序
- 跨平台兼容:支持 Windows/macOS/Linux,Python 3.10+ 即可运行
WorkBuddy Usage Status —— Agent 执行指令
本文件是给 AI 的执行说明书,用户视角的安装、读图、故障排查见 README.md;指标算法口径见 DATA-GUIDE.md。
触发条件
当用户明确指向 WorkBuddy 自身、表达以下意图时调用本技能。description 已含触发词,此处强化判断与收紧边界:
- 想查看 / 生成 / 导出自己的 WorkBuddy 使用统计、工作量、成本看板;
- 关心 token 消耗、模型分布与性价比、思考效率、错误监控、用量高峰日等任一维度在 WorkBuddy 本机 trace 中的数据;
- 想对账某段时间 WorkBuddy 用了多少积分。
典型触发说法:「看看我的 WorkBuddy 用了多少 token」「生成 WorkBuddy 用量看板」「WorkBuddy 积分消耗对账」「哪个模型最划算」「哪天用量最高」。命中任一具体说法即触发;只有泛指「做个统计图表」且未指向 WorkBuddy 本机用量时不易触发。
反向触发词:用户意图指向以下任一情况时,本技能不适用,应直接告知用户:
- 想查看 / 统计其他产品,如 Cursor、VS Code、Trae、Claude 等第三方系统的用量、数据、分析;
- 仅泛指"导出我的数据 / 做个统计图表 / 生成看板",未明确指向 WorkBuddy 本机用量;
- 想为任意数据集生成通用可视化 / 报表;本技能只读取
~/.workbuddy下的数据文件,不具备通用图表能力。
遇到上述情况,回复要点:本技能只读取并可视化 WorkBuddy 本机(~/.workbuddy)的使用数据,不涉及其他产品或通用数据;请确认是否要分析 WorkBuddy 自身用量,或改用对应产品的工具。
执行步骤
抽取器仅依赖 Python 标准库,运行前无需 pip 安装任何包。在技能目录下运行:
python3 scripts/usage_extractor.py [--out <输出目录>] [--home <数据根>] [--credit-xlsx <路径>] [--seed <旧快照>] [--no-archive]
--out <dir>:输出目录,默认当前工作目录。--home <dir>:指定数据根目录,默认~/.workbuddy;日常使用不要加,仅迁移或测试时用。--credit-xlsx <path>:可选。传入从workbuddy.cn用量页导出的 xlsx,作为参考补充:只补入本地没有逐次明细的日期。仅当用户明确要求与官方账单对账时再加。--seed <path>:旧快照种子(usage-status.json或历史 dashboard HTML)。一次性导入其每日总量进入持久覆盖层,恢复已被 WorkBuddy 30 天清理的日期,逐笔明细不可追溯。导入后持久生效,无需重复传入。只取其中的 token 等总量字段;旧快照的 credit 是按会话首现日挂出来的旧口径,不再采用。--no-archive:禁用自动归档合并,默认开启。
执行后在该目录生成 6 个文件:
workbuddy-usage-status-dashboard-<时间戳>.html—— 数据内联、Chart.js 外链,双击/预览即可看,零外网依赖;文件名带生成时间戳,每次生成独立文件;usage-status.json—— 原始聚合数据,供二次处理;usage-status.js——window.USAGE_STATUS = {...},供 HTML 通过<script>直接引入,以此避开file://的 fetch 跨域限制。chart.umd.min.js—— 图表引擎,由抽取器从 skill 包复制到输出目录,需与 HTML 同目录存放。usage-full-<时间戳>.csv—— 全量数据 CSV,分区清单见DATA-GUIDE.md§4.11,与看板同源;14 个分区写在同一个文件里。usage-full-<时间戳>.xlsx—— 全量数据 xlsx,与 CSV 同源,14 个分区对应 14 个工作表、首行冻结。
⚠ 产物敏感性提醒:
usage-status.json/usage-status.js/ dashboard HTML / 全量 CSV 与 xlsx 中均含会话标题与用户提问原文摘要(提问最长 300 字;看板内展示默认脱敏,数据文件内为原文截断),分享或提交到仓库前请先检查敏感性。
⚠ 30 天缓存期(重要):WorkBuddy 现对本机 traces 只保留 30 天,本 skill 每次运行会自动把数据归档到
~/.workbuddy/usage-archive/,之后无论 trace 是否被清理,看板始终是全量视图——但归档只在运行时发生,所以需至少每 30 天运行一次,建议设置自动任务,断档超 30 天期间的 trace 无法追溯;首次运行只能看到最近 30 天。可用--seed <旧快照>导入历史快照恢复更早的每日总量。
交付方式
生成完成后,在输出目录找到最新生成的 workbuddy-usage-status-dashboard-*.html,按文件名时间戳取最大者,用 present_files 打开预览交回给用户。
只把看板 HTML 作为预览项交付,不要放入其他产物。 全量 CSV 一旦放进预览项,用户打开时看到的是报错而不是数据:该文件由 14 张列数各异的表拼接而成,首行不是表头,WorkBuddy 的内置预览会把它交给在线表格引擎,该引擎按首行字段数判定列数,往下读到 10 列、15 列的行即解析失败。CSV 与 usage-full-<时间戳>.xlsx、usage-status.json 一律以文件路径形式在回复里说明。
约束与口径
- 读写与网络边界:① 读——仅以只读模式读
~/.workbuddy下的workbuddy.db、traces/、projects/*/*.jsonl,从中提取<user_query>提问摘要供下钻显示,以及每次模型调用的providerData.rawUsage.credit与模型名用于逐日 credit;不修改 WorkBuddy 自身数据、不上传任何数据、不读取任何 API key/密码;② 写——仅在输出目录生成 6 个产物文件,并在~/.workbuddy/usage-archive/维护本地归档以对抗 30 天 trace 清理(--no-archive可关闭);③ 网络——全程零网络请求,不发起任何出站连接。xlsx 由脚本用标准库zipfile与 XML 自行拼装,不引入任何第三方依赖。 - 指标口径:token 为权威主指标,本地 trace 带精确时间戳,按请求本地时区归日,精确;credit 取自本地会话文件里每一次模型调用的精确积分,按调用时间归日,同样精确,并可再按模型与时段拆分。各指标的具体算法、聚合口径与已知限制见
DATA-GUIDE.md,不要凭空编造数字。 - 数据完整性:抽取器顶部警告条已列出被跳过/解析失败的 trace 与会话,报告可能不完整属正常现象,如实告知用户即可。
- 产物确定:每次运行仅生成上述 6 个固定文件(dashboard HTML /
usage-status.json/usage-status.js/chart.umd.min.js/usage-full-<时间戳>.csv/usage-full-<时间戳>.xlsx),规模由本地~/.workbuddy数据量天然限定,不存在无界输出。
相关文档
README.md:用户视角的安装、使用场景、读图指南、故障排查。DATA-GUIDE.md:指标计算的唯一真相源,含算法、聚合口径、图表参数、归因方法、已知限制。CHANGELOG.md:版本变更记录与安全等级评估。